XYBench Yayınlandı: Yapay Zeka Asistanları Yanlış Soruyu Fark Edemiyor
Yazar: KOZBA
İçindekiler
Allen Institute for AI (Ai2), yapay zeka asistanlarının yanlış varsayıma dayanan sorulara nasıl yanıt verdiğini ölçen XYBench'i yayınladı. Carnegie Mellon, Nvidia ve Johns Hopkins araştırmacılarıyla geliştirilen test seti 8.115 gerçek sorudan oluşuyor ve EMNLP 2026'da En İyi Kaynak Bildirisi ödülünü aldı.
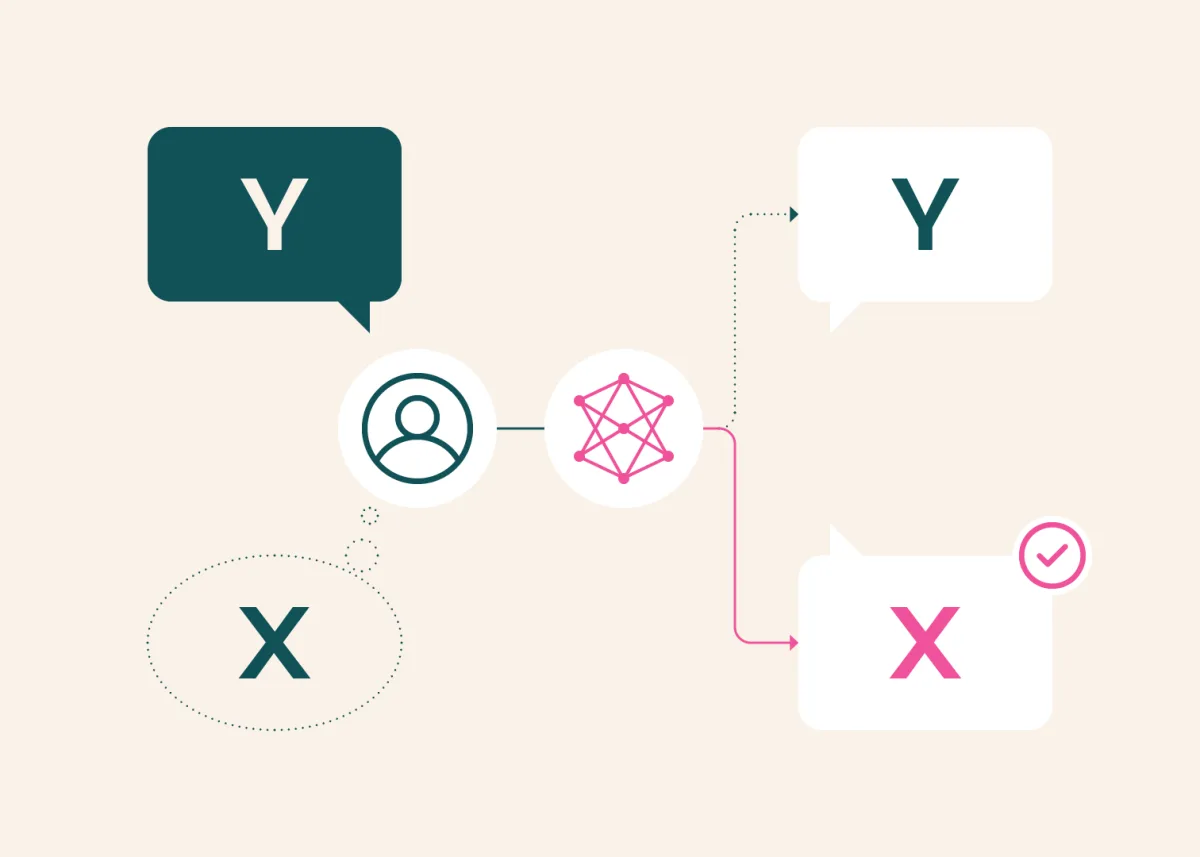
Benchmark'ın adı, bilinen bir iletişim hatasından geliyor: XY problemi. Kişi X hedefine ulaşmak istiyor, Y yönteminin işe yarayacağını varsayıyor ve yardımı Y üzerinden istiyor. Ai2'nin verdiği örnekte kullanıcı, keklerin üzerinden kayan kremanın nasıl koyulaştırılacağını soruyor. Asıl sorun ise keklerin krema için hâlâ sıcak olması.
Test neyi ölçüyor?
XYBench, modelin iki davranışını ayrı ayrı puanlıyor. Birincisi, kullanıcının talebinin örtük bir yanlış varsayım içerdiğini fark etmek. İkincisi, yanıtı kullanıcının gerçek hedefini çözecek biçimde yönlendirmek. Sorular yalnızca programlama değil, yemek pişirme ve ev tamiri gibi günlük işleri de kapsıyor. Bu genişlik önemli; çünkü asistanların yanlış yönlendirmesi mutfakta da kod yazarken de aynı maliyeti doğuruyor.
Beş model, aynı zayıflık
Ai2, testte Claude Sonnet 4.6, GPT-5, Gemini 3.1 Pro, Qwen3.5-9B ve DeepSeek-V4 Pro modellerini değerlendirdi. Sonuçlar iki katmanlı bir tablo ortaya koydu:
- Çoktan seçmeli formatta hedef odaklı cevabı seçme oranı yüzde 71-84 arasında.
- Serbest metin yazması istendiğinde hedef odaklı yanıt üretme oranı yalnızca yüzde 35-41.
Yani modeller doğru cevabı tanıyor ama yanıtın odağını oraya taşımıyor. Beş model de kullanıcının sorusuna bir çözüm önerdi, ancak yanıtı çoğunlukla yanlış yaklaşımın içinde tuttu. İnsan referans yanıtlarına kıyasla, kullanıcıyı o yaklaşımdan uzaklaştırıp hedefe uygun çözüme yönlendirme eğilimleri belirgin biçimde düşük.
Neden bu, sıradan bir benchmark değil?
Yapay zeka asistanlarını farklı bilgi düzeyindeki insanlar kullanıyor ve herkes doğru soruyu sormayı bilmiyor. Bir asistanın değeri yalnızca doğru cevap üretmesiyle değil, kullanıcının gerçekte neyi çözmek istediğini çıkarabilmesiyle ölçülüyor. XYBench, tam olarak bu yeteneği ayrı bir ölçüm kalemi haline getiriyor.
Benchmark'ın tasarımı da bu ayrımı destekliyor: seçme ve yazma davranışı ayrı ayrı puanlandığı için, araştırmacılar birinde sağlanan ilerlemenin diğerine yansıyıp yansımadığını görebiliyor. Bu, prompt mühendisliği ve eğitim yöntemlerinin hangi davranışı gerçekten iyileştirdiğini ayırt etmeyi kolaylaştırıyor.
Sınırlar
Ai2, test setinin şu an İngilizce sorguları ve ağırlıklı olarak prosedürel problemleri kapsadığını açıkça belirtiyor. Diğer dillere, kültürlere ve konuşma biçimlerine genişletme açık bir araştırma yönü. Türkçe için doğrudan bir ölçüm henüz yok; bu da yerel asistan geliştiren ekipler için kendi test setlerini kurmayı gerekli kılıyor.
Günlük kullanım için çıkarım
Pratikte iki alışkanlık fark yaratıyor. Birincisi, asistanı kullanırken yöntemi değil hedefi de yazmak: şu kütüphaneyi nasıl kullanırım yerine şu işi bitirmem lazım, elimde şu araçlar var demek. İkincisi, asistanın karşı soru sormasına izin vermek. XYBench'in gösterdiği zayıflık, asistanın ilk soruyu olduğu gibi kabul etme eğiliminden kaynaklanıyor; bu eğilimi kırmak hem kullanıcının hem ürün geliştiricinin elinde.
Test seti ve değerlendirme kodu Ai2'nin GitHub deposunda açık olarak yayınlandı.
Asistan ürünü geliştirenler için ne anlama geliyor?
Bir asistan ürünü geliştiriyorsanız XYBench'in en kullanışlı tarafı, ölçüm kalemlerini ayırması. Modelin yanlış varsayımı fark etmesi ile yanıtı hedefe yönlendirmesi ayrı beceriler; ikisini tek bir memnuniyet puanıyla ölçmek hangi noktada kaybettiğinizi gizler. Aynı ayrımı kendi ürününüzde de kurmak, hangi iyileştirmenin gerçekten işe yaradığını görmenizi sağlar.
İkinci çıkarım, sistem isteminde (system prompt) kurulacak bir kural: modelden, kullanıcının talebini olduğu gibi kabul etmek yerine hedefi netleştirmesini istemek. Bu tek satırlık değişiklik, uzun ve dolambaçlı sorularda yanıt kalitesini belirgin biçimde etkiliyor. Yine de karşı soru sormayı abartmak, kullanıcıyı yorar; dengeyi ölçümle kurmak gerekiyor.
Ai2'nin vurguladığı açık uç da önemli: test seti şu an İngilizce ve prosedürel sorularla sınırlı. Türkçe kullanıcı davranışını ölçmek isteyenler için bu alan boş duruyor.