TurboFieldfare Açık Kaynak Yayınlandı: 26B Model 8 GB Mac'te 2 GB Bellekle Çalışıyor
Yazar: KOZBA
İçindekiler
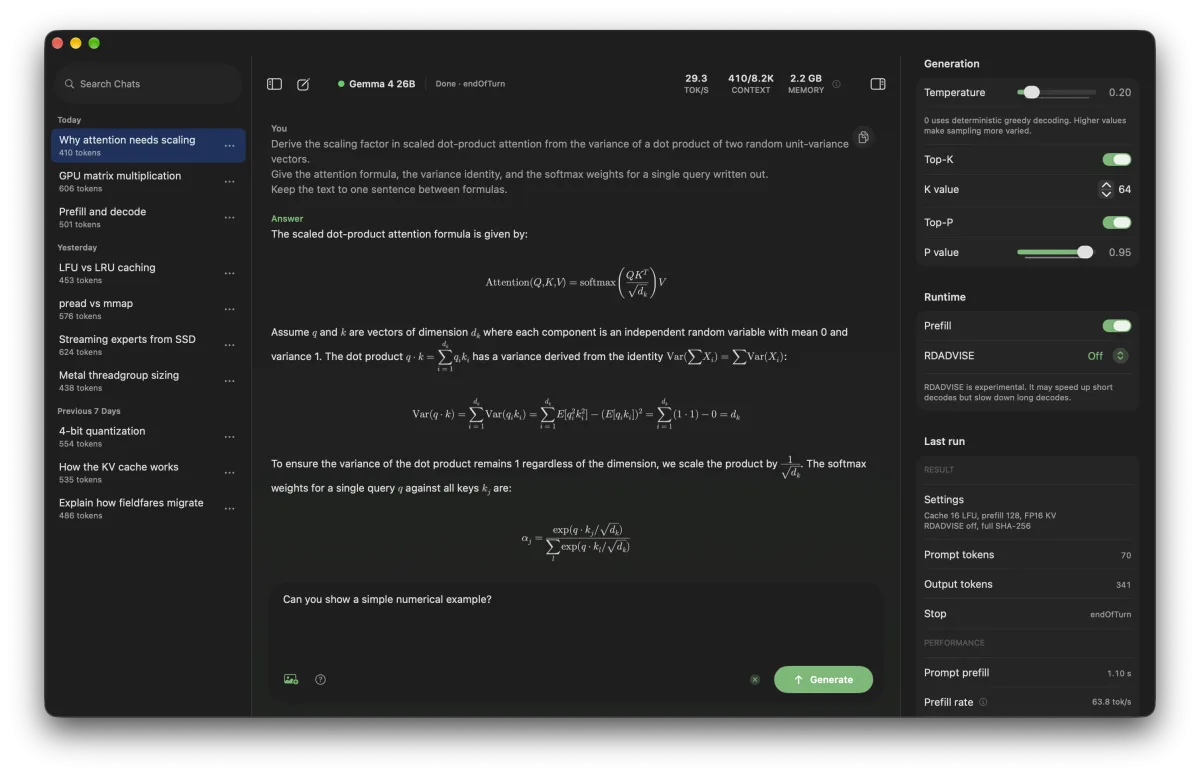
Yerel yapay zeka dünyasında ilginç bir proje kısa sürede dikkat çekti. iOS ve Metal mühendisi Andrey Mikhaylov'un geliştirdiği TurboFieldfare, Google'ın Gemma 4 26B-A4B modelini 8 GB bellekli Apple Silicon Mac'lerde çalıştırıyor. Projenin iddiası net: 14,3 GB ağırlığı olan bir modeli, çıkarım sırasında yaklaşık 2 GB RAM ile yürütmek.
Depo 17 Temmuz 2026'da oluşturuldu ve bugün 7 binden fazla yıldız, 470'ten fazla çatal sayısına ulaştı. Kod Apache 2.0 lisansıyla yayımlandı; proje kendi deposunda, MLX ya da llama.cpp üzerine yazılmış bir sarmalayıcı değil, modele özel yazılmış bir çalıştırma ortamı olarak tanımlanıyor.
Nasıl oluyor da 26B model 8 GB'a sığıyor?
Yöntem, modelin tamamını belleğe yüklememeye dayanıyor. TurboFieldfare, modelin paylaşılan 1,35 GB'lık çekirdeğini ve FP16 hassasiyetindeki KV önbelleğini RAM'de tutuyor. Geri kalan uzman katmanlarını ise her token için yalnızca gerekenleri SSD'den akıtıyor. Gemma 4 26B-A4B zaten seyrek bir mimari: 26 milyar toplam parametrenin token başına yalnızca yaklaşık 3,88 milyarı etkinleşiyor. Bu yapı, "bellekte tut" yerine "diskten akıt" stratejisini mümkün kılıyor.
Ağırlıklar MLX affine 4-bit, grup 64 biçiminde; yönlendirici 8-bit, paylaşılan ve yönlendirilen uzmanlar 4-bit. Bu da toplam ağırlığı yaklaşık 14,3 GB'a indiriyor. Projenin ilk satırı zaten motivasyonu özetliyor: "Bellek pahalandı. Ben de 26 milyar parametreli bir modele yaklaşık 2 GB bütçe verdim."
Ölçülen hızlar
Depodaki ölçümlere göre 8 GB M2 MacBook Air'de kod çözme hızı 5,1 ile 6,3 token/saniye arasında. Aynı model M5 MacBook Pro'da 31-35 token/saniye seviyesine çıkıyor. Bu, bir sohbet asistanı için yavaş ama kullanılabilir bir hız; toplu metin işleme için ise sabır gerektiriyor.
Donanım tarafında koşullar net: macOS 26 veya üzeri, Swift 6.2 ve Metal 4. Derleme Swift Package Manager ile kaynaktan yapılıyor, hazır kurulum paketi yok. İlk çalıştırmada uygulama modeli indirip yeniden paketliyor; bu yaklaşık 15 GB'lık bir indirme anlamına geliyor.
Neden önemli?
Yerel model çalıştırmanın önündeki en büyük engel bellek. 4-bit kuantizasyondan geçmiş 26B'lik bir model, işletim sistemi ve KV önbelleği de hesaba katıldığında 16 GB'lık bir Mac'te bile rahat çalışmıyor. TurboFieldfare, uzman katmanlarını diske taşıyarak bu sınırı esnetiyor. Sonuç, "model ne kadar büyükse o kadar çok RAM gerekir" varsayımının her zaman doğru olmadığını gösteriyor.
Benzer bir yaklaşımı llama.cpp gibi genel amaçlı motorlarda da görmek mümkün; ancak buradaki fark, çözümün tek bir modele ve tek bir donanım ailesine göre uçtan uca optimize edilmesi. Projede 103 ölçümlü deneyin sonuçları ayrı bir dosyada yayımlanmış durumda; çekirdek optimizasyonlarından önbellek ve G/Ç davranışına kadar ayrıntılar açık.
Sınırlar ve kimler için uygun?
Önce sınırlar: Motor yalnızca Gemma 4 26B-A4B modelini çalıştırıyor, genel amaçlı bir çalıştırma ortamı değil. Performans doğrudan SSD hızına bağlı; yavaş bir diskte token üretimi belirgin biçimde düşer. Modeli indirmek ve derlemek teknik bilgi gerektiriyor. Ayrıca projenin OpenAI uyumlu yerel sunucusu deneysel olarak işaretlenmiş.
Buna karşılık 8 GB'lık bir MacBook Air'i olan ve buluta veri göndermeden deney yapmak isteyen bir geliştirici için bu, gerçekçi bir seçenek. Gizlilik gerektiren metin işleri, çevrimdışı prototipleme ve model davranışını kurcalamak isteyenler projenin ana kitlesi.
Türkiye'de pratik anlamı
Türkiye'de Apple Silicon Mac kullanan geliştirici sayısı azımsanmayacak düzeyde ve çoğu 8 ya da 16 GB bellekle çalışıyor. 16 GB'lık bir makinede bu yaklaşım, RAM'in büyük kısmını tarayıcı ve editör gibi araçlara bırakırken modeli arka planda çalıştırmayı mümkün kılıyor. Bu, özellikle yerel ajan denemeleri yapanlar için anlamlı.
Yine de beklentiyi doğru kurmak gerekiyor: 5-6 token/saniye hız, kod tamamlama gibi düşük gecikme isteyen işler için uygun değil. Bu proje daha çok "model gerçekten sığıyor mu?" sorusuna verilmiş mühendislik yanıtı olarak değerli. Açık kaynak olması, benzer tekniklerin başka modellere ve donanımlara taşınmasını da kolaylaştıracak.