İçindekiler
Tavus, San Francisco merkezli yapay zeka araştırma şirketi, gerçek zamanlı yüz yüze görüşmeler için geliştirdiği yeni modeli Griffin'i tanıttı. Şirket, Griffin'i "video Turing testini geçen ilk model" ve dünyanın ilk İnsan Etkileşim Modeli (Human Interaction Model – HIM) olarak duyurdu. 1 Ekim 2026'da yayımlanan tanıtım paylaşımı kısa sürede 12 milyondan fazla görüntülenme ve 30 binden fazla beğeni aldı.
Video Turing testini nasıl geçti?
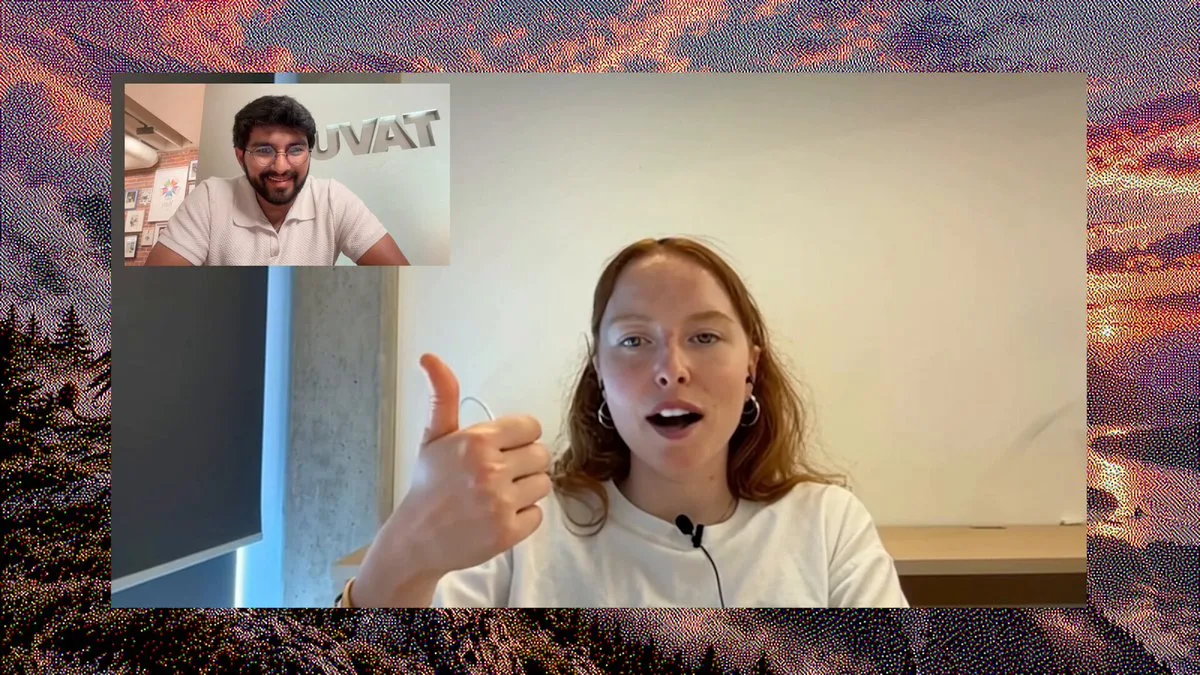
Tavus'un yaptığı kör çalışmada katılımcılar, başka bir katılımcıyla bir dakikalık görüntülü görüşme yaptıklarını düşünerek sohbet etti. Aslında karşı tarafta Griffin ile çalışan bir sistem vardı. Görüşmenin sonunda katılımcılara partnerlerinin bir yapay zeka olabileceği soruldu: 54 kişiden 26'sı, yani %48'i, konuştuğu kişinin gerçek bir insan olduğunu belirtti. Tavus'un önceki sistemi (Phoenix, Sparrow ve Raven bileşenleriyle) aynı testte yalnızca 41 kişide 1 kez, yani %2,4 oranında insan sanılmıştı.
Çalışmanın ayrıntılarında, katılımcıların yarısından fazlasının görüşme boyunca karşısındakinin yapay zeka olabileceğini hiç düşünmediği; şüphelenenlerin ise bunu genellikle ilk 20 saniye içinde hissettiği aktarıldı.
NVIDIA VideoFDB kıyaslamasında birinci
Tavus, Griffin'in NVIDIA'nın VideoFDB kıyaslama testinde birinci olduğunu belirtiyor. Görüntü üretimi (generation) başlığında model 5 üzerinden 3,83 puan alırken, insan referans puanı 3,92 ve bir sonraki en iyi yayımlanmış sistem 2,80 düzeyinde kaldı. Algılama (perception) başlığında ise Griffin 3,73 puanla, insan referansı olan 4,20'nin gerisinde ama rakiplerinin önünde yer aldı. Şirket, gerçek zamanlı tepki metriklerinde bir sonraki en iyi sistemin %37 önünde olduğunu ifade ediyor.
Nasıl çalışıyor?
Griffin, çoğu gerçek zamanlı yapay zekanın kullandığı "röle" yaklaşımını bir kenara bırakıyor. Geleneksel sistemlerde konuşma metne çevrilir, bir dil modeli yanıt yazar, ardından başka sistemler o metni sese ve yüze dönüştürür; her aktarım gecikme ekler ve ton gibi bilgileri kaybeder. Griffin ise algılama, karar verme, konuşma ve görüntü üretimini tek bir mimaride birleştiriyor.
Model full-duplex (tam çift yönlü) çalışıyor: iki taraf da aynı anda konuşup tepki verebiliyor. Bu sayede Griffin cümlenin ortasında bir konuşmayı kesebiliyor, kesilebiliyor ve ekranda gördüğü bir harekete anında yanıt verebiliyor. Şirkete göre model, tek bir referans fotoğrafından kare kare, sandalyenin hareketi ve gölgeler dahil tüm sahneyi gerçek zamanlı üretiyor; sesi ise yaklaşık 10 saniyelik bir kayıttan klonlayabiliyor.
Şimdilik erişim kısıtlı
Griffin, ticari kullanıma açık değil. Tavus, henüz Griffin-Lite adlı araştırma önizlemesini yalnızca seçili güvenilir test kullanıcılarına sunduğunu belirtiyor. Şirket, açıklama (disclosure) ve güvenlik mekanizmalarını tamamladıktan sonra tam sürümü yayınlamayı planlıyor. Bunun nedeni açık: bir insanı insanla ayırt edilemeyecek kadar iyi taklit edebilen bir sistem, müşteri desteği ve eğitim gibi alanlarda güçlü bir arayüz sunarken, aynı özelliklerle bir kişinin taklit edilmesini de kolaylaştırabiliyor.
Ne anlama geliyor?
Griffin, insan-bilgisayar etkileşiminde yeni bir kategori (HIM) iddiasıyla geliyor. Metin tabanlı sohbet botlarının aksine, konuşmanın görsel ve işitsel boyutunu tek modelde birleştirmesi, sesli ve görüntülü arayüzlerdeki "robotik" hissini ortadan kaldırmayı hedefliyor. Ancak açıklanan rakamların bir kısmı henüz hakem değerlendirmesinden geçmiş çalışmalara değil, şirketin kendi testlerine ve NVIDIA kıyaslamasına dayanıyor. Tavus, Griffin-Lite'a erişim için başvuru formu sunuyor.