NVIDIA 22 Hint Dili İçin 2,8 Trilyon Tokenlık Veri Setini Açtı: Üretim Reçetesi de Yayında
Yazar: KOZBA
İçindekiler
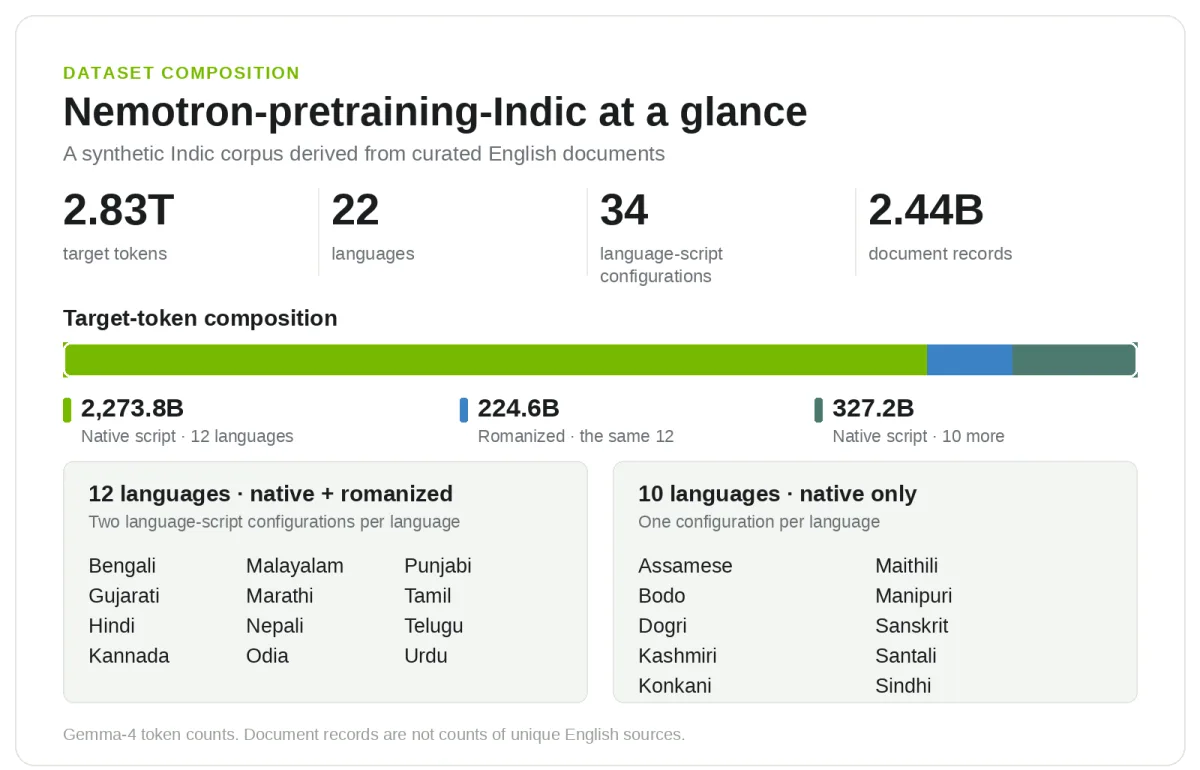
NVIDIA, IIT Madras ve üniversitenin Hint dilleri araştırma laboratuvarı AI4Bharat ile birlikte Nemotron-pretraining-Indic-v1 veri setini duyurdu. Yaklaşık 2,8 trilyon token ve 22 Hint dilini kapsayan veri seti, onu üreten açık ve GPU hızlandırmalı veri üretim boru hattıyla birlikte yakında yayınlanacak. Veri seti, Hindistan Anayasası'nda yer alan 22 dili kapsıyor; bu diller 2011 nüfus sayımına göre Hintlilerin yüzde 97'sinin, yani yaklaşık 1,2 milyar kişinin ana dili.
Veri setinin içinde ne var?
Korpus iki grup dil yapılandırmasından oluşuyor. Bengalce, Gucaratça, Hintçe, Kannada, Malayalam, Marathi, Nepalce, Odia, Pencapça, Tamilce, Telugu ve Urduca için hem özgün yazı hem de Latin harfli (romanize) veri bulunuyor. Assamca, Bodo, Dogri, Keşmirce, Konkani, Maithili, Manipuri, Sanskritçe, Santali ve Sindhi dilleri yalnızca özgün yazıyla geliyor. Toplamda 34 dil-yazı kombinasyonu oluşuyor.
Gemma-4 tokenizer'ı ile sayılan veri seti 2.601,0 milyar özgün yazı tokenı ve 224,6 milyar romanize token içeriyor. Buradaki özgün yazı, metnin yazı sistemi anlamına geliyor; içerik yine İngilizceden çevriliyor. Romanize ise İngilizce çeviri değil, Hint dilindeki metnin Latin harfleriyle yazılmış hâli. Bu ayrım, eğitim karışımı kurulurken önem taşıyor: aynı içeriği farklı yazı maruziyetiyle sunan kayıtlar token bütçesiyle karıştırılmamalı.
İngilizce belgelerden Indic eğitim verisine
Korpus, Nemotron-CC-v2'nin 15 alt kümesinden gelen belgeler üzerine kuruluyor; web metni, soru-cevap malzemesi, matematik, kod ve diğer özel içerik türleri kapsanıyor. Üretim, NVIDIA'nın açık kaynak sentetik veri çerçevesi NeMo Data Designer ile yürütülüyor; her kayıt kaynak belgesine kadar izlenebiliyor.
12 dilli iş akışı
Bu grupta belgeler baştan sona çevriliyor; böylece model paragraflar, tablolar ve denklemler arasında bağlam kullanabiliyor. Çeviri için tam belge karşılaştırmasıyla Gemma-4-31B-it seçildi. Çeviri sonrası aynı model her çıktıyı İngilizce kaynağıyla karşılaştırıyor. Multidimensional Quality Metrics (MQM) esinli bir rubrik anlam, akıcılık, terminoloji, üslup ve biçimlendirmeyi puanlıyor; yalnızca 100 üzerinden en az 75 alan çıktılar korunuyor. Daha düşük puanlı çıktılar geri bildirimle onarılıp yeniden değerlendiriliyor. Bu süreç, özgün yazı ve romanize veri dahil 438,4 milyar token kurtardı.
Kabul edilen özgün yazı çevirileri romanize verinin de başlangıcı. Bir alt küme Latin harflere dönüştürülüp sonuç özgün yazı girdisiyle karşılaştırılıyor. İnsan karşılaştırmasında bu iki adımlı yaklaşımın, doğrudan İngilizceden romanize metin üretmeye kıyasla daha az halüsinasyon ve daha az artık İngilizce ürettiği görüldü.
10 dilli iş akışı
Diğer on dilde uzun belge kalitesi ve yazı kararlılığı sorunları için iş akışı uyarlanıyor. Çeviri, Bodhan AI'nın İngilizce ile 22 Hint dili arasında belge düzeyinde çalışan Indic Translate modeliyle yapılıyor; değerlendirmeyi yine Gemma-4-31B-it üstleniyor. Sekiz dilde tüm belge yaklaşımı korunuyor. Uzun Santali belgelerinde örtüşen pencerelerle çeviri yapılıp belge yeniden kuruluyor; Manipuri için metin önce Bengal yazısına, sonra kendi yazısı Meitei Mayek'e dönüştürülüyor.
Indic sürekli ön eğitim ne kazandırdı?
Nemotron 3.5 Super VL teknik raporu, Indic sürekli ön eğitim (CPT) öncesi ve sonrası kontrol noktalarını karşılaştırıyor. 100 milyar tokenlık bütçenin yüzde 10'u, yani 10 milyar token, sentetik ve doğal Indic metin karışımına ayrıldı. Beş Indic bilgi ve akıl yürütme kıyaslamasında puanlar arttı: MILU, Indic MMLU-Pro, Indic ARC-Challenge, Indic ARC-Easy ve Indic GSM8K. Kazanımlar 4,98 ile 9,82 puan arasında. Yayınlanan model, önceki nesil Nemotron 3 Super'a kıyasla gösterilen altı görev kıyaslamasının beşinde daha yüksek puan alırken IFEval 1.5'te 2,04 puan geriledi; Sarvam AI'nın IndiVibe kıyaslamasının dört boyutunda iyileşme var.
Nasıl kullanılır ve sınırlar
Veri seti dil, yazı ve bölge etiketleriyle yapılandırılıyor; örneğin hi-Deva-IN Devanagari Hintçeyi, hi-Latn-IN romanize Hintçeyi temsil ediyor. NeMo Data Designer için açık kaynak Nemotron Bharat çeviri eklentisi çeviri ve değerlendirme promptlarını, isteğe bağlı onarımı, pencereleme ve yazı dönüşümünü sağlıyor.
NVIDIA, çevirinin Hint dillerinde yazılmış özgün metnin yerini tutmadığı ve yerel bilgi ile kültürü garanti etmediği uyarısını yapıyor; korpusun doğal Indic metinlerle birleştirilmesini öneriyor. Kalite değerlendirmesi ağırlıklı olarak otomatik ve örneklemeli insan incelemesiyle destekleniyor; on dilli iş akışının daha geniş ana dil doğrulamasına ihtiyacı var. AI4Bharat ayrıca Indic-LLM-Eval-Suite adlı açık kıyaslama koleksiyonunu geliştiriyor.