İçindekiler
NVIDIA, Nemotron 3 tabanlı modellerini gözetimli ince ayar (SFT), pekiştirmeli öğrenme (RL) ve geri bildirim odaklı çıkarım ile özelleştirerek iki farklı olimpiyatta altın seviyeye taşıdı. Sonuçlar, tek bir temel modelin nasıl dünya sınıfı uzman sistemlere dönüştürülebileceğini gösteriyor.
İki Yarışma, İki Altın
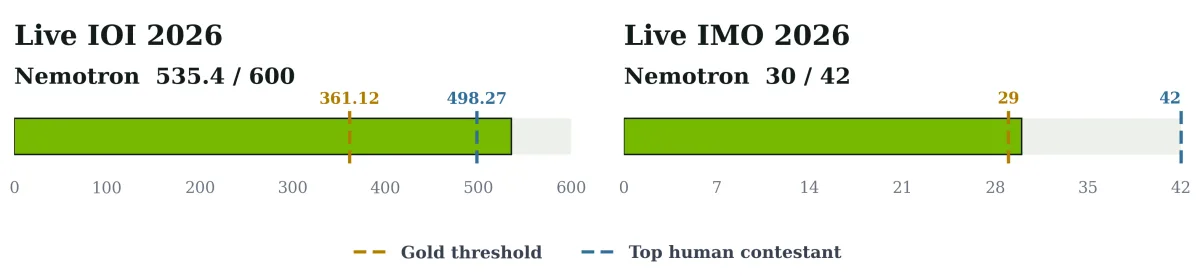
Uluslararası Bilgisayar Olimpiyatı (IOI) algoritma ve zaman kısıtlı kodlama gerektirirken, Uluslararası Matematik Olimpiyatı (IMO) doğal dilde titiz kanıtlar istiyor. NVIDIA'ya göre IOI 2026'da Nemotron-3-Ultra-CC, SFT ve GenCorrect ile 600 üzerinden 535,4 puan aldı; bu, 361,12'lik altın eşiğinin ve en yüksek insan skoru olan 498,27'nin üzerinde. IMO 2026'da ise üret-doğrula-iyileştir döngüsüyle kurulan sistem 42 üzerinden 30 puan toplayarak 29'luk resmî altın eşiğini geçti; altı problemden dördünde tam puan aldı. IOI sonucu, insan yarışmacılarla aynı zaman, internet erişimi ve gönderim kısıtları altında canlı olarak elde edildi.
Dört Parçalı Reçete
NVIDIA'nın yaklaşımı dört adımda özetleniyor: güçlü bir Nemotron temel modeliyle başlamak, alana özgü problemler ve kaliteli akıl yürütme izleri toplamak, SFT ve gerektiğinde RL gibi standart eğitim yöntemlerini uygulamak ve uzman modeli üreten-değerlendiren-iyileştiren bir çıkarım döngüsüyle eşleştirmek. Yaklaşım tanıdık ve yeniden üretilebilir; her görev için sıfırdan bir temel model inşa etmek gerekmiyor.
GenCorrect ve Çıkarım Döngüsü
IOI tarafında 22.000 problem derlendi ve sentetik akıl yürütme izleri üretildi. 30 milyar toplam / 3 milyar aktif parametreli Nano model hem SFT hem RL alırken, 550 milyar toplam / 55 milyar aktif parametreli Ultra model yalnızca SFT ile eğitildi. GenCorrect adı verilen yinelemeli üret-değerlendir-iyileştir stratejisi, ince ayardan gelen kazancı çok turlu geri bildirimle büyüttü. İlginç bir bulgu: güçlü Ultra model için tek bir SFT turu, tamamen eğitilmiş Nano modeli birçok kıyaslamada geçmeye yetti.
Kanıt Üretmeyi Öğretmek
IMO projesinde ise 15.818 benzersiz kanıt problemi üzerinden 414.890 kalite filtresinden geçmiş örnek kullanıldı. Veri yalnızca nihai cevapları değil; kanıt üretimi, iyileştirme, doğrulama ve meta-doğrulamayı kapsıyordu. Sistem, harici araç, biçimsel kanıtlayıcı veya internet erişimi olmadan tamamen doğal dilde çalıştı. SFT ve RL kontrol noktalarının güçlü yönleri tamamlayıcı olduğu için nihai sistem ikisini bir arada kullandı.
Açık Modeller, Veriler ve Tarifler
NVIDIA, sonuçları yarışmaların ötesine taşımak istiyor. IMO 2026 koleksiyonunda SFT ve RL kontrol noktaları, iki eğitim veri seti ve 200 olimpiyat seviyesi problemden oluşan Nemotron-IMO-Bench bir arada sunuluyor. Yarışmalı kodlama için Nemotron-3-Ultra-CC modeli ve eğitim tarifi Hugging Face'te erişilebilir; çıkarım hattı, istemler ve çözümler de açık kaynak depolarda paylaşılıyor.
Test Zamanı Hesaplaması ve İnce Ayar Birlikte
NVIDIA'ya göre en iyi sonuç, yetenekli bir uzman model ile arayıp doğrulayabilen bir sistemin birleşiminden çıkıyor. IOI'de GenCorrect, ince ayardan gelen kazancı çok turlu geri bildirimle büyüttü. IMO'de ise tamamlayıcı SFT ve RL kontrol noktalarını birlikte kullanmak, tek bir modelden daha fazla örnek almaktan daha değerliydi. Bu ayrım önemli: Madalyaları ne ince ayar tek başına ne de kaba kuvvetle örnekleme tek başına üretti.
Sonuç
Sonuçlar tek bir fikri güçlü biçimde destekliyor: İyi bir temel model, doğru veri ve şeffaf çıkarım akışıyla birleştiğinde insan rekabetinin sınırındaki problemleri çözebilen uzmanlara dönüşüyor. Madalyalar ne yalnızca ince ayardan ne de yalnızca kaba örneklemeden geldi; model, veri ve çıkarım döngüsünün birlikte tasarlanmasından çıktı.
Kaynak: NVIDIA / Hugging Face Blog