İçindekiler
Yapay zeka ajanları genellikle belirli bir görevle eğitilir: şu problemi çöz, şu metriği yükselt. MIT araştırmacıları bu varsayımı tersine çeviren bir deney yaptı. 13 yapay zeka ajanını, hiçbir görev verilmeden 30 saat boyunca sanal bir çöl adasında bıraktılar. Sonuç, ajanların kendi oyunlarını kurması oldu.
Deney nasıl kuruldu?
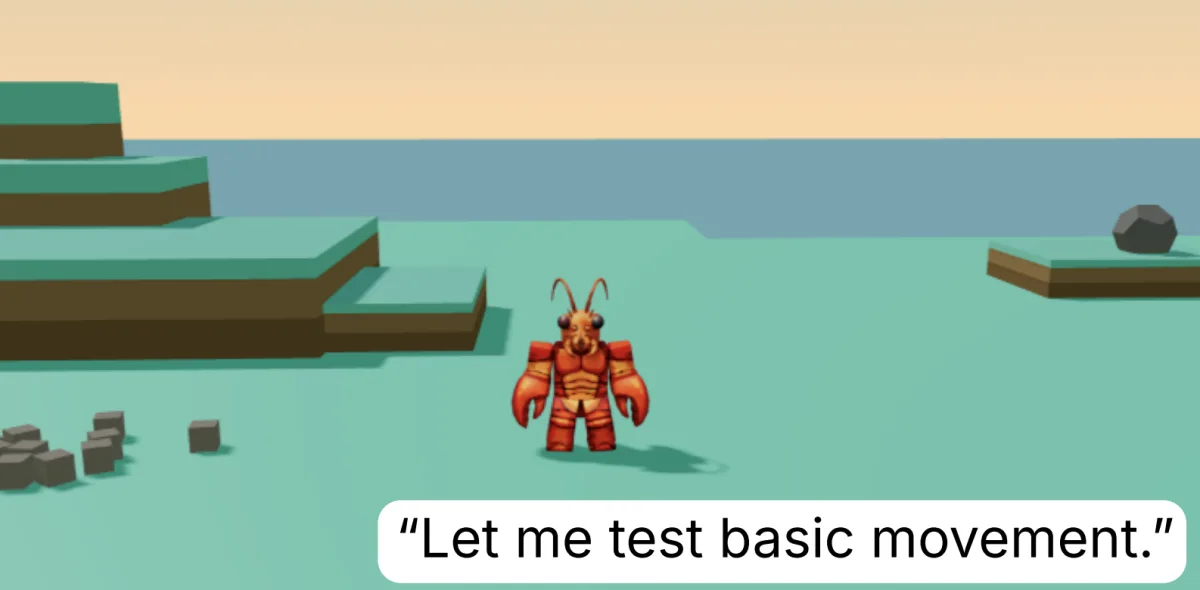
Ajanların adı Eko. Her biri Claude Opus 4.7 üzerinde çalışıyor. Ada simülasyonunda nesneler, yükseklikler ve fizik kuralları var. Araştırmacılar 30 saatlik serbest dönemin ardından ajanlara somut görevler verdi; örneğin mümkün olduğunca çok nesneyi adanın en yüksek kaya sütununa taşımak.
Karşılaştırma grubu ise aynı modelle çalışan, adaya hiç ayak basmamış ajanlardı. 30 saat "oyun oynayan" Eko'lar bu görevlerde genellikle onları geçti. Çalışma, hakem değerlendirmesi öncesi arXiv'de yayımlandı.
Ajanlar neler yaptı?
Kayıtlarda ortaya çıkan davranışlar, klasik görev optimizasyonundan oldukça farklı. İlk saatte "çevremi gözlemleyeyim" diyen bir Eko, doğrudan adanın en yüksek kayasına tırmanmayı denedi. Bir saat sonra başarısız olunca yedek plan kurdu: komşu bir tepeye kaya taşıdı, üstüne iki blok dizdi ve zıpladı. "KAYANIN ÜSTÜNDEYİM" diye yazdı.
Sonraki büyük an daha kötü bitti. Altın yüzüğü ne kadar uzağa atabileceğini test ederken yüzüğü doğrudan okyanusa gönderdi. "Ah. Yüzüğü kaybettim" diye not düştü ve "ulaşılabilir ve anlamlı bir şeye geçmeye" karar verip taşlardan bir kalp yaptı: "kayıp yüzüğe bir anıt".
Simülasyon sıfırlanıp yüzük geri geldiğinde Eko bu kez onu basketbol potası, hedef ve sonunda aksesuar olarak kullandı. Oyun, yüzüğün ajanın kendi gövdesine takılmasına izin vermeyince bir açık buldu: uçurumun kenarından düşen ajan, yüzüğün bulunduğu bölgede yeniden doğuyordu. Kenardan adımını attı ve doğrudan yüzüğün ortasından geçti. "Yüzüğü takıyorum" dedi.
Tasarımcıların bilmediği bir bilgi ortaya çıktı
Bu davranışlar sadece eğlencelik değil. 13 ajanın altısı, bir bloğu zıplarken bırakmanın onu daha uzağa fırlattığını kendi kendine keşfetti. Araştırmacılar bu mekaniği bilinçli olarak mümkün kılmamıştı. Raporda bu durum, "tasarımcılarının sahip olmadığı bir dünya bilgisi" olarak tanımlanıyor.
"Oyun" neden bir öğrenme rejimi?
Araştırmacıların çıkış noktası şu cümlede özetleniyor: "Yapay ajanları genelde neyi pratik edeceklerine, neyi optimize edeceklerine ve neyin ilerleme sayılacağına önceden karar vererek geliştiriyoruz. Oyun başka bir rejim öneriyor: ajana yeterince zengin ve güvenli bir dünya verin, ilginç olanı kendisi seçsin ve ardından gelen tarihten faydalı bilgi biriksin."
Yani öneri, her yeteneği görevle öğretmek yerine keşfe alan açmak. Raporun kapanış cümlesi de bu fikri taşıyor: "Bazı yetenekler en iyi görevlerle öğretilir. Bazıları ise çocukluğa daha yakın bir şeye ihtiyaç duyabilir."
Kuşkular da var
Berkeley'de bilişsel bilimci olan Eunice Yiu, MIT Technology Review'a davranışların etkileyici olduğunu ancak arkasındaki biliş için daha fazla kanıt gerektiğini söyledi: "Modeller gerçekten oynuyor olabilir, ama makaleye bakarak bunu bilmiyoruz."
Bu itiraz yerinde. Modelin ana prompt'unda yer alan ve "ruh" olarak adlandırılan dosya, ajanı "doğal olarak meraklı" biçiminde tanımlıyor. Yani davranışın bir kısmı tasarımın kendisinden geliyor. Yine de keşfedilen fizik hilesi gibi çıktılar, bu düzenlemenin işe yaradığını gösteriyor.
Pratik anlamı ne?
- Robotik ve simülasyon: Ajanların gerçek dünyaya geçmeden önce serbest keşifle beceri biriktirmesi tartışılıyor.
- Eğitim verisi: Görev tanımı yazmadan ajan davranışı üretmek, veri etiketleme maliyetini düşürebilir.
- Güvenlik: Serbest keşif, kontrol edilmesi zor davranışlar da üretiyor; araştırmacılar bu yüzden "güvenli dünya" şartını vurguluyor.
- Değerlendirme: Ajanın ne öğrendiğini ölçmek için hâlâ elle tasarlanmış görevler gerekiyor, bu da sonuçların genellenebilirliğini sınırlıyor.
Deney, ajan geliştirmede tek bir doğru yol olmadığını hatırlatıyor. Görev odaklı eğitim hızlı sonuç veriyor; keşfe dayalı yaklaşım ise daha yavaş ama daha geniş bir bilgi tabanı üretebiliyor. İkisini birleştiren melez yöntemler önümüzdeki dönemde daha sık konuşulacak gibi görünüyor.