Liquid AI LFM3 Ailesini Yayınladı: 1,7B Metinden Sesli-Görsel Omni Modele
Yazar: KOZBA
İçindekiler
Liquid AI, LFM3 model ailesini yayınladı. Aile tek bir modelden oluşmuyor: metin için LFM3-1.7B, görsel için LFM3-VL-2B, ses için LFM3-Audio-2B ve görsel ile sesi birlikte işleyen LFM3-Omni-2B aynı çatı altında geliyor. Şirketin blog yazısındaki çerçeve "göreve özel çok modlu modeller kurmak" üzerine.
LFM3 ailesinde hangi modeller var?
- LFM3-1.7B: Metin üretimi için temel model. Yapılandırılmış JSON çıkarma gibi görevlerde ince ayara uygun.
- LFM3-VL-2B: Görsel ve metin girdisini birlikte işleyen model; görsel açıklama ve görsel soru-cevap için.
- LFM3-Audio-2B: Ses girdisi alıp metin ve sesi iç içe üretebilen model.
- LFM3-Omni-2B: Görsel ve sesi birlikte alıp yanıt üreten birleşik model.
Ortak nokta boyut: tüm aile 2B sınıfında ya da altında. Liquid AI'nin tercihi, cihaz üstünde ve tek GPU'da çalışabilecek modeller üretmek. Hugging Face'teki model kartlarında da bu ölçek doğrulanıyor.
Mimari tarafında ne değişti?
Blog yazısı, modelin "daha ifade gücü yüksek omurga" olarak tarif edilen mimari değişikliklerine yer veriyor:
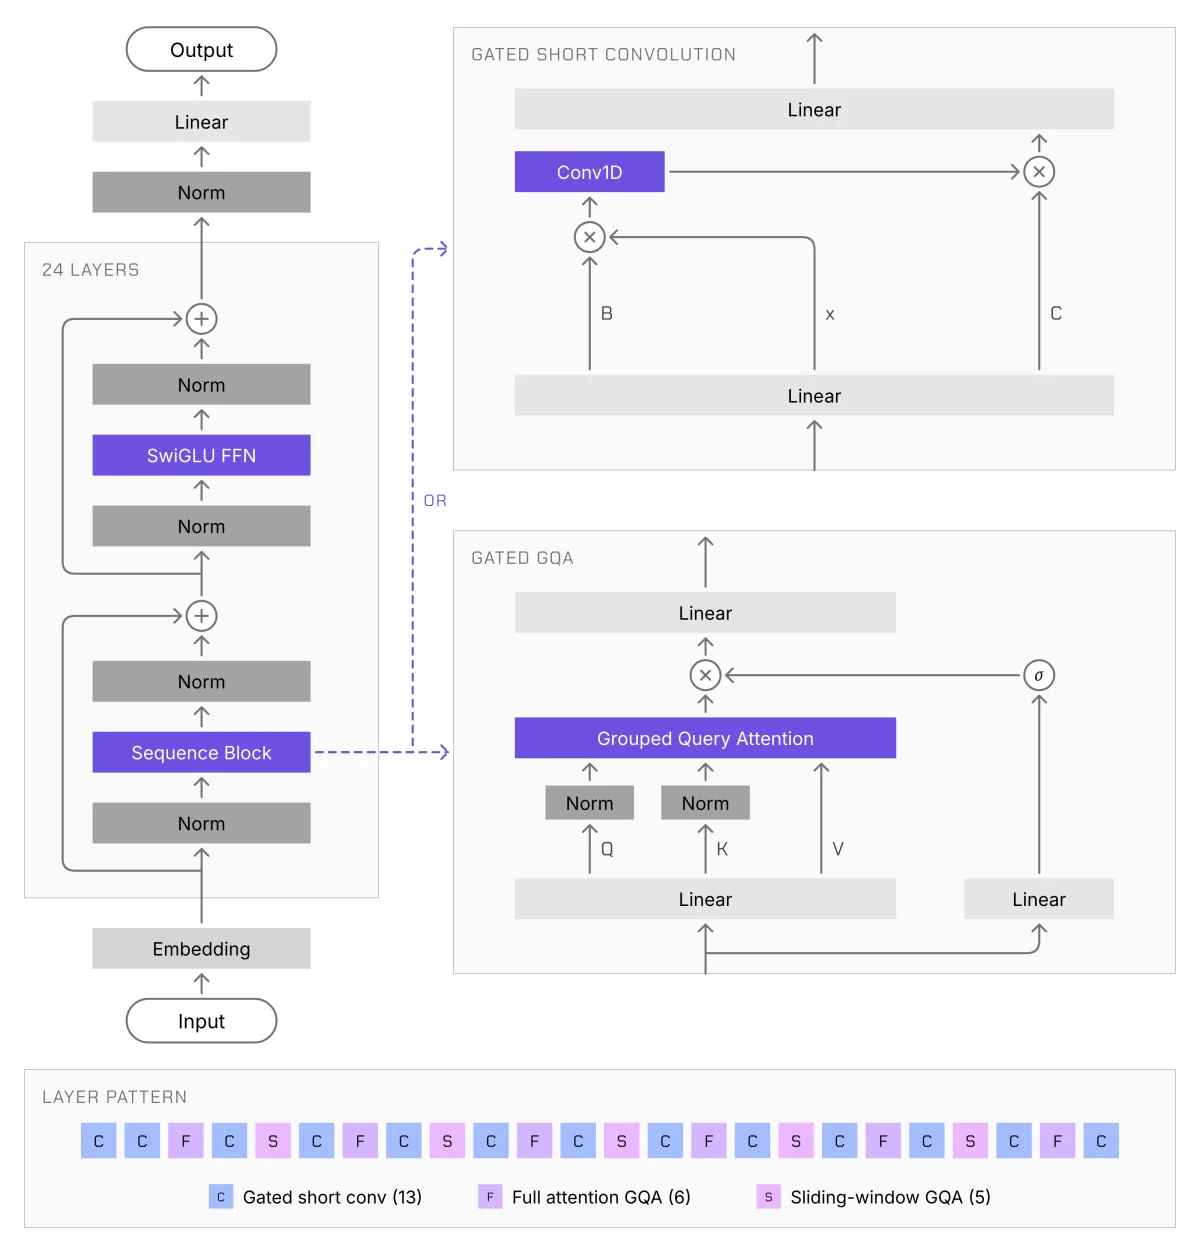
- Kısmi RoPE: Global dikkat katmanları, her kafanın yalnızca en yüksek frekanslı yarısını döndürüyor. Böylece diğer yarı mesafeden bağımsız olarak içerik üzerinde eşleşiyor. Kayan pencere dikkat (SWA) katmanlarında ise tam RoPE korunuyor.
- Sandwich norm: Her blok hem girişini hem çıkışını normalize ederek aktivasyonları dengeli ölçekte tutuyor.
- Hibrit dikkat: Global dikkat ile kayan pencere dikkat katmanları bir arada kullanılıyor; uzun bağlamda maliyet düşerken yakın bağlamın çözünürlüğü korunuyor.
Bu detaylar, modelin neden küçük boyutta makul kalite hedeflediğini açıklıyor. Amaç frontier modellerle genel sohbette yarışmak değil; belirli bir görevi uçta, düşük maliyetle çözmek.
İnce ayar tarafı: tek GPU yeterli
Liquid AI'nin en pratik vaadi, her modelin tek GPU'da ince ayara uygun olması. Blog yazısında dört ayrı TRL defteri (notebook) paylaşılıyor:
- SFT: Dağınık dokümanlardan yapılandırılmış JSON çıkarma.
- DPO: Getirilen dokümana dayanarak yanıt verme ya da yanıt vermeyi reddetme.
- GRPO: 108 araçlı bir telefon uygulamasında doğru aracı çağırma.
- CPT: Ham metinden yeni bir dil öğrenme; örnek olarak Türkçe seçilmiş.
Türkçe için sürekli ön eğitim (CPT) defterinin resmî örnekler arasında olması, Türkçe içerik üreten ekipler açısından kayda değer. Küçük bir modeli kendi dil verinizle güçlendirmek, büyük bir modele göre maliyeti çok daha öngörülebilir bir iş.
Nasıl çalıştırılır?
Modeller Hugging Face Transformers üzerinden standart boru hattıyla yüklenebiliyor. Görsel ve ses modellerinde AutoModelForImageTextToText ve AutoProcessor kullanılıyor; ses tarafında çıktı ses kodu (audio code) olarak geliyor ve bir codec ile dalga formuna çevriliyor. Pratik anlamı: özel bir servis kurmadan, yerel bir Python ortamında denemek mümkün.
Kimler için anlamlı?
LFM3 ailesi üç senaryoda öne çıkıyor: veriyi buluttan çıkarmak istemeyen kurumlar, gecikmenin kritik olduğu cihaz üstü uygulamalar ve tek bir dar görevde yüksek doğruluk isteyen ekipler. Örneğin bir muhasebe ekibi dağınık faturalardan JSON çıkarmak için 1.7B'lik modeli kendi verisiyle eğitebilir.
Buna karşılık genel amaçlı, geniş bilgi gerektiren sorularda 2B sınıfı bir modelin frontier modellerle aynı performansı vermesi beklenmemeli. Liquid AI de metni bu şekilde kuruyor: göreve özel, küçük ve eğitilebilir.
Sonuç
LFM3, "her işi yapan tek büyük model" anlatısının karşısına "küçük, çok modlu, kendi verinle eğitilebilir model" tezini koyuyor. Karar noktası, tek GPU'da ince ayarın gerçekten vaat edilen kaliteyi verip vermemesi ve Türkçe gibi dillerde CPT sonuçlarının ne kadar tutarlı çıkması olacak. Modeller Hugging Face üzerinde açık; denemek için ek onay gerekmiyor.