Liquid AI d1 Karar Modellerini Açık Kaynak Yayınladı: Uçta 16 Milisaniyede Yanıt
Yazar: KOZBA
İçindekiler
Liquid AI, "d1" karar modeli ailesinin iki yeni üyesini açık ağırlıklı olarak yayınladı: d1-3B ve deneysel d1-omni-600M. Bu modeller, alışıldık üretken modeller gibi token üretmek yerine tek bir ileri geçişte (forward pass) soruyu yanıtlıyor. Amaç, uç cihazlarda hızlı ve yapılandırılmış kararlar almak.
Karar Modeli ile Üretken Model Arasındaki Fark
Üretken dil modelleri metni adım adım üretir; karar modelleri ise verilen durumu tek seferde değerlendirip belirlenmiş sorulara ("iade talebi mi?", "hangi ekip bakmalı?", "ne kadar acil?") doğrudan yanıt verir. Bu yapı, gecikmenin kritik olduğu sınıflandırma, yönlendirme ve güvenlik kontrolleri için tasarlanmış. Modeller Liquid AI'nin LFM (Liquid Foundation Models) temelleri üzerine inşa edilmiş.
d1-3B ve d1-omni-600M
d1-3B, şirketin son görsel-dil modeli LFM2.5-VL-3B üzerinden eğitildi ve metin ile görsel girdilerini kabul ediyor. d1-omni-600M ise çift yönlü bir kodlayıcı olan LFM2.5-Encoder-350M temelinden geliyor; görsel ve ses kodlayıcıları eklenerek metin+görsel ya da metin+ses kombinasyonlarını işleyebiliyor. Şirket, d1-omni-600M'i erken araştırma sürümü olarak tanımlıyor ve üzerinde çalışmaya devam ediyor.
Benchmark Sonuçları
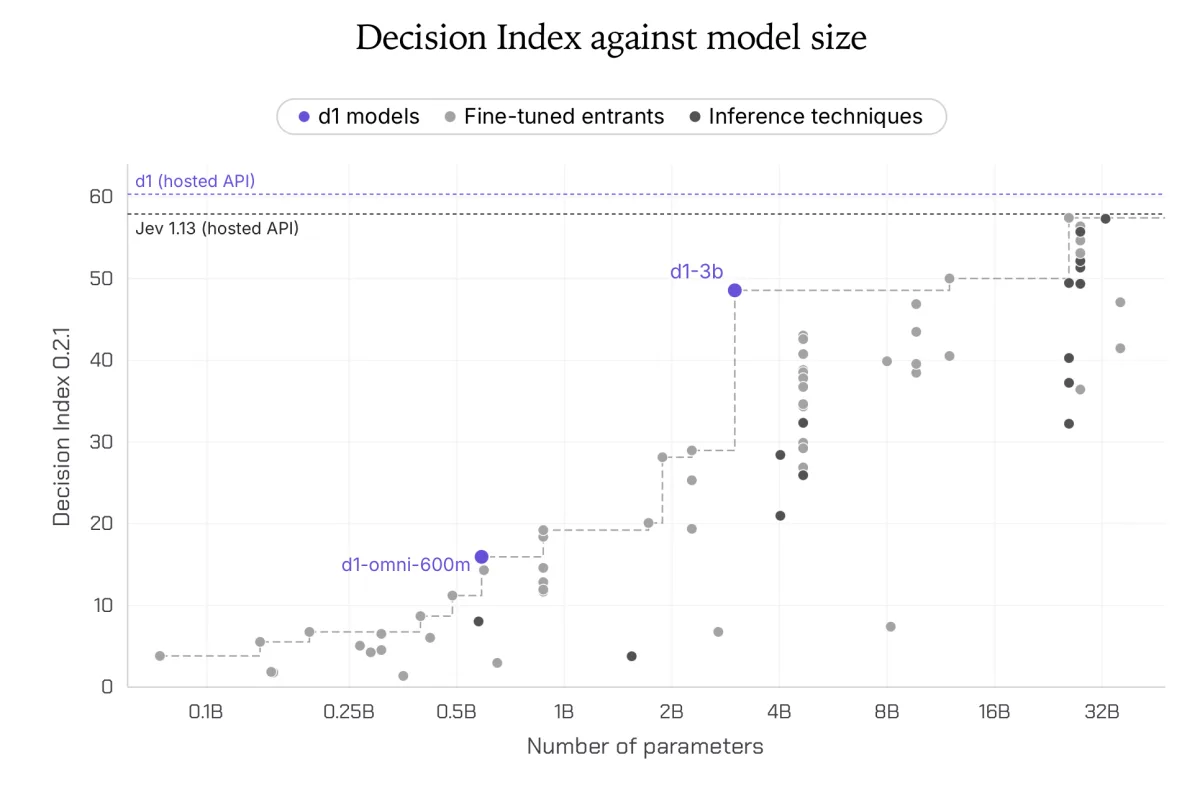
Liquid AI, modelleri okuduğunu anlama, toksisite tespiti, niyet sınıflandırma, tıbbi soru-cevap ve diller arası anlama gibi alanlarda yedi açık veri kümesinde test etti. d1-3B, 82,9 ortalama puanla tablodaki en yüksek skoru aldı ve 4B ile 9B boyutundaki tüm modellerin önüne geçti. d1-omni-600M ise 78,4 puanla, dörtte bir parametreyle Decider 2B'yi (77,1) geçti. Modele göre görev bazında skorlar değişiyor: d1-3B SQuAD 2.0'da 83,3 ve PubMedQA'da 68,3 alırken; d1-omni-600M Civil Comments'te 95,8 ve PAWS-X'te 79,5 ile öne çıkıyor.
Hız: Uçta 16 Milisaniye
Modellerin en dikkat çekici yanı hızı. NVIDIA ile yapılan değerlendirmede d1-3B, bir soruyu Jetson AGX Thor'da 16 ms, Jetson AGX Orin 64 GB'de 26 ms ve Jetson Orin Nano'da 50 ms'de yanıtlıyor. Apple M5 Pro'da bu süre 30 ms. Üç soru sorulduğunda süre yalnızca 1,3 kat artıyor; AGX Thor 16 ms'den 20 ms'ye çıkıyor. GPU tarafında ise d1-3B, NVIDIA RTX 4090'da 8 ms ve AMD MI325X'te 9 ms ile 10 ms'nin altında yanıt veriyor. 384 piksel bir görsel de RTX 4090'da 17 ms'de işleniyor. Bu değerler, modelin gerçek zamanlı uç senaryolarda kullanılabileceğini gösteriyor.
Nerede Kullanılır?
Liquid AI, d1 modellerini hızlı ve yapılandırılmış karar gerektiren, çok modlu girdilerin olduğu işler için öneriyor: çağrı merkezi taleplerini sınıflandırma, hangi ekibin ilgilenmesi gerektiğini belirleme, aciliyet skorlama, içerik moderasyonu ve görsel ya da ses içeren cihaz üstü kontroller. 600 milyon parametreli sürüm, ayak izinin küçük olması gereken yerlerde devreye giriyor.
Açık Ağırlıklı Yayınlamanın Anlamı
İki modelin de açık ağırlıklı olması, kurumların karar modellerini kendi altyapısında, dış servise veri göndermeden çalıştırabilmesi anlamına geliyor. Sağlık, finans ve kamu gibi veri gizliliğinin kritik olduğu alanlarda bu, bulut tabanlı çözümlere kıyasla belirgin bir avantaj. Aynı zamanda 3B ve 600M gibi küçük boyutlar, modellerin özel donanım gerektirmeden Jetson ve benzeri uç kartlarda çalışmasını mümkün kılıyor. Liquid AI'nin hamlesi, her karar için büyük bir modele başvurma yaklaşımına pratik bir alternatif sunuyor; bu da gecikmeyi, maliyeti ve veri aktarımını azaltıyor.
Nasıl Başlanır?
Her iki model de Hugging Face'te açık ağırlıklı olarak indirilebiliyor (LiquidAI/d1-3b ve LiquidAI/d1-omni-600M). Kullanmak için transformers 5.14 ve üzeri, torch, torchvision ve pillow gerekiyor. Modeller kendi kodlarını taşıdığı için trust_remote_code=True ile yükleniyor. Liquid AI ayrıca System One Arcade adlı bir Hugging Face Space'te demoları denemeye açtı.
Sonuç
Liquid AI'nin açık kaynak hamlesi, yapay zekanın bulut bağımlılığını azaltıp karar alma işini doğrudan cihaza taşımayı hedefliyor. 16 ms'lik yanıt süreleri, sınıflandırma ve moderasyon gibi görevlerde bulut turu beklemenin gereksizleşebileceğini gösteriyor. Modelin yaygınlaşması, uçta çalışan yapay zeka uygulamalarına ilgiyi artırabilir.
Kaynak: Liquid AI / Hugging Face Blog (7 Ekim 2026)