Baidu Unlimited OCR 2: 3,3B Parametreyle Sınırsız Uzunlukta Belge Ayrıştırma
Yazar: KOZBA
İçindekiler
Baidu, belge ayrıştırma tarafında Unlimited OCR 2 modelini yayınladı. 27 Ekim 2026'da duyurulan sürüm, 3,34 milyar parametreyle çalışıyor ve MIT lisansıyla açık ağırlık olarak sunuluyor. Modelin iddiası net: belge uzunluğu arttıkça maliyeti artmayan bir ayrıştırma.
Çözmeye çalıştığı problem
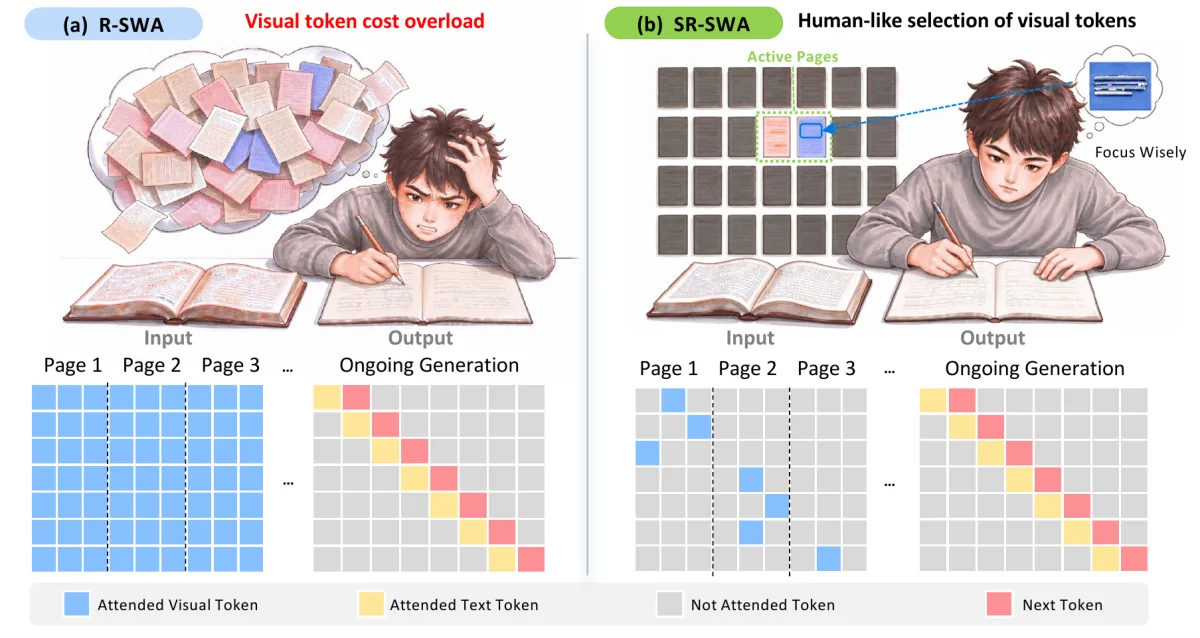
Görsel tabanlı dil modelleri, bir belgenin sayfalarını görsel token'lara çevirerek okuyor. Sayfa sayısı arttıkça dikkat mekanizmasının maliyeti ikinci dereceden büyüyor; bellek ve gecikme şişiyor. Uzun PDF'lerde, arşiv taramalarında ve yüzlerce sayfalık raporlarda bu, modelin tıkanma noktası haline geliyor.
Baidu'nun önceki sürümü Unlimited OCR de aynı yönde atılmış bir adımdı; ekip o dönem DeepSeek-OCR'ı bir adım ileri taşımayı hedeflediklerini söylemişti.
SR-SWA nasıl çalışıyor?
Yeni sürümün merkezinde Sparse Reference Sliding Window Attention (SR-SWA) var. Yöntem, metin ile görsel arasındaki dikkat etkileşimini çok uzun dizilerden sabit boyutlu bir referans kümesine indirgiyor; model kartında bu küme için 512 token örneği veriliyor.
Sonuç, adım başına çözümleme gecikmesinin ve bellek kullanımının belge uzunluğundan neredeyse bağımsız kalması. Başka bir deyişle model, sınırlı bir bağlam penceresi içinde "sınırsız ufuklu" ayrıştırma yapıyor.
Ölçüm ve benchmark
Model kartı, hem onlarca sayfalık testlerde (MPDocBench) hem de yüzlerce sayfalık uç örneklerde (MarathonDocBench) en iyi sonucu bildirdiğini söylüyor. MarathonDocBench de aynı gün, 27 Ekim'de ultra uzun belge ayrıştırma için yeni bir kıyaslama seti olarak yayınlandı.
Not: bu skorlar modeli geliştiren ekibin kendi değerlendirmesi. Bağımsız bir kıyaslama sonucu değil.
Teknik künye
- Parametre: 3,34 milyar; mimari UnlimitedOCRForCausalLM.
- Lisans: MIT. Ağırlıklar Hugging Face, ModelScope ve Baidu Cloud üzerinden erişilebilir.
- Çıkarım: Transformers ile hızlı test, üretim için SGLang öneriliyor.
- Test ortamı: NVIDIA A800-80GB, torch 2.13, transformers 4.52.1.
- Diller: çok dilli.
Çok sayfalı çıkarım
Modelin pratik avantajı infer_multi fonksiyonunda görünüyor: bir belgenin tüm sayfaları sırayla verildiğinde tek istekte ayrıştırılıyor ve model sayfalar arası bağlamı kullanabiliyor. Yani başlık bir sayfada, tablo üç sayfa sonra olsa bile ilişki korunabiliyor. PDF'ler 300 dpi'de görüntüye çevrilerek besleniyor.
Kimler için anlamlı?
Büyük arşivleri dijitalleştiren kurumlar, uzun sözleşme ve raporları işleyen hukuk/finans ekipleri, RAG hatları için belge hazırlayan geliştiriciler bu modele bakabilir. Tek sayfalık fiş ve fatura işleri için ise 3,3B parametre gereğinden ağır kalabilir; daha küçük OCR modelleri yeterli olur.
Açık lisans ve yerel çalıştırma imkânı, özellikle veriyi buluta çıkarmak istemeyen ekipler için belirleyici. Modelin yüzlerce sayfayı tek istekte işleyebilmesi, uzun belge iş akışlarında parçalama-birleştirme zahmetini de azaltıyor.
"OCR 3.0" ne anlama geliyor?
Baidu ekibi bu sürümü "OCR 3.0" döneminin başlangıcı olarak tanımlıyor: uzun ufuklu ayrıştırmadan sınırsız ufuklu ayrıştırmaya geçiş. Ayrım basit ama sonuçları büyük.
Klasik OCR tek sayfalık görüntüden karakter çıkarır. Görsel dil modelleri sayfa düzenini, tabloları ve okuma sırasını da anlar; fakat bağlam penceresi dolduğunda belgeyi parçalamak gerekir. Parçalama, sayfa arası ilişkileri koparır: bir tablonun başlığı bir parçada, devamı diğerinde kalır. Unlimited OCR 2 bu kopmayı ortadan kaldırmayı hedefliyor.
Pratikte ne değişiyor?
- Tek istek: yüzlerce sayfalık bir kitap ya da rapor, sayfa sayfa değil bütün olarak işlenebiliyor.
- Sayfa arası bağlam: başlık, dipnot ve tablo devamlılığı korunuyor.
- Sabit maliyet: gecikme ve bellek, belge uzunluğuyla birlikte büyümüyor.
- Yerel çalıştırma: ağırlıklar açık olduğu için veri dışarı çıkmadan işlenebiliyor.
Hangi durumlarda zorlanır?
Model kartındaki benchmark iddiaları güçlü olsa da gerçek dünya belgeleri farklı davranıyor. El yazısı, düşük tarama kalitesi, eğik fotoğraflar ve çok sütunlu gazete düzeni hâlâ zor alanlar. Ayrıca 300 dpi görüntüye çevirme adımı, çok büyük belgelerde disk ve işlem yükü demek.
Bir başka pratik konu donanım: 3,34 milyar parametre, tek bir üst seviye tüketici GPU'sunda çalışabilir ama yüzlerce sayfalık belgede bellek yönetimi yine de planlama gerektiriyor.
Rakiplerden farkı
Aynı günlerde Çin kaynaklı OCR modelleri hızla çoğalıyor: DeepSeek-OCR serisi, PaddleOCR ve MiniCPM-OCR gibi seçenekler var. Unlimited OCR 2'nin ayrıştığı nokta, uzunluk sınırını mimari düzeyinde ele alması. Diğer modeller çoğunlukla sayfa bazlı doğrulukta yarışıyor; bu model ise belge ölçeğinde sabit maliyet vaat ediyor.
Bu yüzden doğru soru "hangi model daha doğru okuyor" değil, "hangi model benim belge uzunluğumda tıkanmıyor" olmalı.
Sonuç
Unlimited OCR 2, uzun belge işleyen ekipler için kayda değer bir seçenek: MIT lisansı, açık ağırlıklar ve tek istekte çok sayfalı çıkarım bir arada. Yine de üretime almadan önce kendi belgelerinizle doğruluk testi yapmak gerekiyor; model kartındaki skorlar geliştiricinin kendi ölçümü.