Aynı Model, Farklı Harness: CUGA, Hermes ve Deep Agents Karşılaştırması
Yazar: KOZBA
İçindekiler
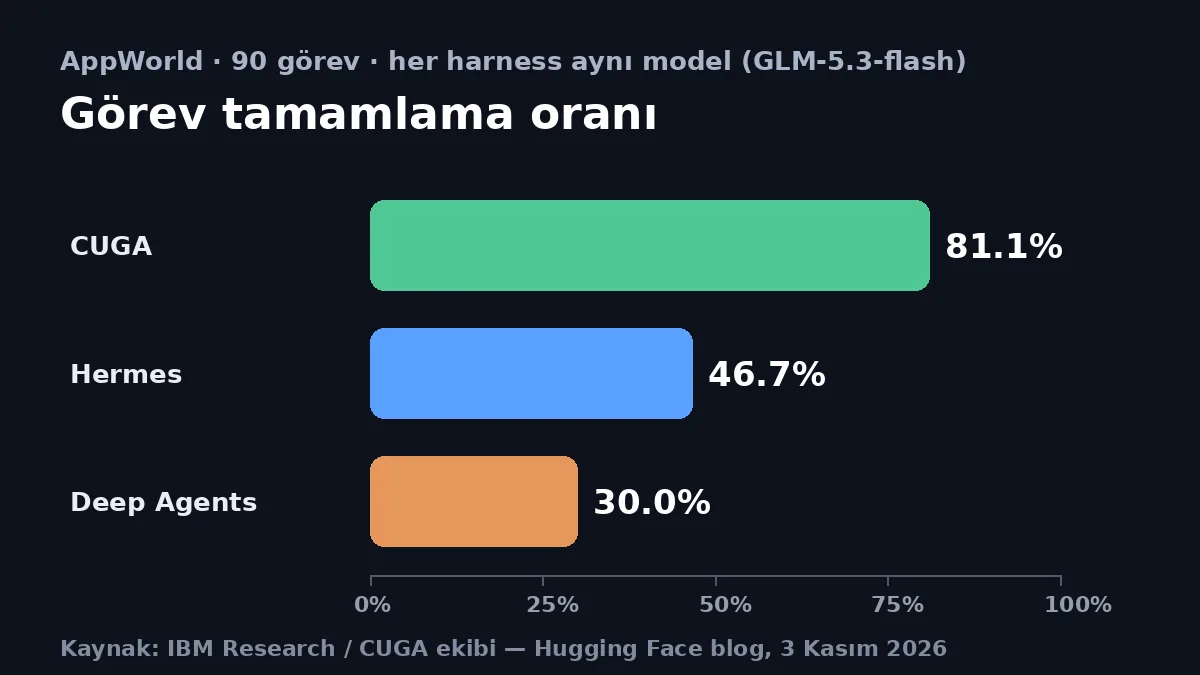
Ajan geliştirirken en sık sorulan soru "hangi modeli kullanayım?" oluyor. 3 Kasım'da Hugging Face blogunda yayımlanan bir karşılaştırma ise başka bir değişkeni işaret ediyor: harness, yani modelin etrafındaki planlama, araç seçimi, kod yürütme ve doğrulama katmanı. Topluluk listeleri artık yaklaşık 200 farklı ajan harness'ı sayıyor. CUGA ekibinin deneyinde aynı model, farklı harness'larda yüzde 30 ile yüzde 81 arasında sonuç verdi.
Neden harness konuşulmalı?
Harness'ın etkisi ilk kez ölçülmüyor. Blog yazısının aktardığı bir analizde aynı GLM-5.2 modeli, yalnızca harness değiştirilerek SWE-bench Pro'da yüzde 23'ten yüzde 52'ye çıkmış. Bu, "en iyi harness hangisi?" sorusunun yanlış olduğunu gösteriyor; doğru soru, "benim iş yüküm ve modelim için hangi harness uyuyor?"
Yazı bu ayrımı yaparak başlıyor: Nous Research'ün Hermes'i sürekli açık kişisel asistanlar, LangChain'in Deep Agents'ı ise araştırma gibi uzun ve çok adımlı görevler için tasarlandı. İkisi de kendi işlerinde iyi. Kurumsal iş ise başka bir iş: ajanlar CRM ve ödeme gibi iş sistemlerine dokunuyor ve model ne karar verirse versin geçerli kalması gereken kurallara uymak zorunda. CUGA (ConfigUrable Generalist Agent), IBM'in tam bu iş için geliştirdiği açık kaynak harness.
Deney nasıl kuruldu?
Karşılaştırma AppWorld üzerinde yapıldı: e-posta, ödeme ve dosya depolama gibi 9 uygulama ve 457 API içeren, çok adımlı görevlerden oluşan bir benchmark. Tüketici uygulamaları üzerinden kurumsal otomasyonun ihtiyaç duyduğu yeteneklerin bir alt kümesi test ediliyor; oturum açma, API dokümanı okuma, sayfalama ve birden fazla uygulamada durum değiştirme gibi.
Her harness aynı açık ağırlıklı modeli, GLM-5.3-flash'ı kullandı. 30 senaryodaki 90 görev, her görev için tek deneme ile çalıştırıldı. Tüm koşular Harbor değerlendirme çerçevesiyle yapıldı ve kurulum harbor-eval deposunda herkese açık.
Sonuçlar: yüzde 30, 46,7 ve 81,1
Görev tamamlama oranları CUGA için 81,1 (90 görevde 73), Hermes için 46,7 (42/90), Deep Agents için 30,0 (27/90) çıktı. Ekip, asıl anlamlı sayının senaryo bazlı tutarlılık olduğunu söylüyor: bir senaryo, ancak üç varyantının üçü de geçtiğinde başarılı sayılıyor. Burada fark daha da açılıyor; CUGA 30 senaryonun 20'sinde, Hermes 8'inde, Deep Agents yalnızca 2'sinde tam tutarlılık sağladı. Yani CUGA sadece daha sık doğru sonuç vermiyor, aynı görevin farklı varyantlarında da daha istikrarlı.
Puanlar nereden geliyor?
Model her koşuda aynı olduğu için fark harness'tan geliyor. CUGA'nın AppWorld yapılandırmasında çalışan özellikleri üç gruba ayırmak mümkün.
- İşi planlamak: Görev, uygulama bazında adımlara bölünüyor; her adım 469 aracın tamamını değil, yalnızca kendi uygulamasının araçlarını ve birkaç ortak aracı görüyor. Bir adım başka bir araca ihtiyaç duyarsa find_tools ile arama yapılıyor.
- Kodla hareket etmek: Model, uygulama API'lerini çağıran Python kodu yazıyor (CodeAct) ve bu kod zaman sınırı olan kısıtlı bir sandbox'ta çalışıyor.
- Önce ve sonra kontrol etmek: Veriyi değiştiren her kod bloğu çalışmadan önce denetleniyor; sonuçlar gözden geçirilip ajan planını düzeltebiliyor. Bir liste çağrısı tam sayfa döndürdüğü hâlde sonraki sayfa istenmemişse sayfalama denetimi bunu işaretliyor.
Net etki şu: model daha az karar veriyor, harness daha çok hatayı sonuca ulaşmadan yakalıyor.
Kuralları prompt'a değil runtime'a yazmak
Yazının kurumsal kullanıcı için en önemli kısmı burada. Çoğu ekip ödeme onayı ya da müşteri verisinin şirket içinde kalması gibi iş kurallarını sistem prompt'una yazıyor. Ancak prompt bir talimattır, yaptırım değil: model yanlış okuyabilir, kullanıcı ajanı ikna edebilir, görev ortasında gelen enjekte bir mesaj kuralı değiştirebilir.
CUGA bu kuralları prompt'tan çıkarıp harness'a taşıyor. Politika katmanı koşunun dört noktasında devreye giriyor:
- Kullanıcı niyeti: Intent Guard, eşleşen istekleri ajan hiç harekete geçmeden engelliyor ya da yanıtlıyor; örneğin tüm müşteri kayıtlarını silme talebi.
- Ajan yönlendirmesi: Playbook, ajana standart bir prosedür veriyor; örneğin iade prosedürünü adım adım izlemesi.
- Araç çalıştırma (sert durdurma): Tool Approval, koşuyu bir insanın onayı için durdurup önerilen kodu gösteriyor; ödeme aracı çalışmadan önce birinden onay istenmesi gibi.
- Araç çalıştırma (sert kontrol): Tool Guide ve ToolGuard, araçtan önce koruma kodu çalıştırıyor. Engellenen çağrı politika ihlali döndürüyor ve araç hiç çağrılmıyor; örneğin 1.000 doları aşan ödemeyi bloklamak.
CUGA Apache 2.0 lisanslı, herhangi bir OpenAI uyumlu uç noktayla çalışıyor ve yerelde, özel ya da egemen bulutta Kubernetes üzerinde, hatta hava boşluklu (air-gapped) bir kümede çalıştırılabiliyor. Bütçe limitleri harcamayı sınırlıyor, koşu makbuzları her çalıştırma için token, araç çağrısı ve süre bilgisini gösteriyor.
Sınırlar ve çıkar çatışması
Bu karşılaştırmayı ciddiye alırken üç uyarıyı birlikte okumak gerekiyor. Birincisi örneklem küçük: tek benchmark üzerinde 90 görev, sonuçlar başka iş yüklerine genellenemeyebilir. İkincisi kurulumlar eşit değil; CUGA kendi AppWorld yapılandırmasıyla, diğer ikisi Harbor'ın varsayılan kurulumuyla koştu. Üçüncüsü ve en önemlisi, testi CUGA ekibi yaptı ve yazıda bunu açıkça belirtiyor. Yazının sonunda "Hermes veya Deep Agents'ı daha iyi yapılandırabiliyorsanız konfigürasyonu gönderin, aynı görevlerde yeniden koşup hangi harness kazanırsa yayımlayacağız" daveti var; bu, sonucu kesin bir yargı olarak değil, yapılandırmaya bağlı bir ölçüm olarak okumak gerektiğini gösteriyor.
Hangi iş için hangisi?
Yazı kendi sınırını da çiziyor. Terminalde kodlama ajanı istiyorsanız opencode, Codex veya Claude Code; sohbet uygulamalarında yaşayan sürekli açık kişisel asistan istiyorsanız OpenClaw veya Hermes; boş sayfadan başlayan bir grafik çerçevesi istiyorsanız doğrudan LangGraph öneriliyor. CUGA ise API'ler, uygulamalar ve web arayüzleri üzerinden iş süreçlerini, uygulanabilir kurallar altında otomatikleştirmek isteyenler için.
Buradaki asıl ders model seçiminden bağımsız: ajan performansı, modelin tek başına ne yapabildiğinden çok, etrafındaki kontrol noktalarının ne kadar iyi tasarlandığına bağlı. Kendi ajanınızı değerlendirirken önce "hangi model" değil, "hangi adımda hangi kuralı kim uyguluyor" sorusunu sormak daha verimli olabilir.